Un agent conversationnel peut répondre en quelques secondes et pourtant laisser un client sans solution. Pour une PME, la vraie mesure ne se limite donc pas au nombre de conversations traitées : elle porte sur la justesse des réponses, la résolution réelle des demandes et l’effort demandé aux clients.
Une IA conversationnelle performante comprend le langage courant, répond avec précision et sait passer la main lorsqu’une situation dépasse son périmètre. Ces qualités se mesurent avec des données concrètes, complétées par la lecture d’échanges réels. Sans cette discipline, un taux d’automatisation flatteur peut masquer des erreurs, des abandons ou des transferts mal gérés.
Le bon pilotage associe quelques indicateurs de performance à des tests réguliers. Il permet de vérifier la pertinence des réponses, leur cohérence dans une conversation à plusieurs tours et leur effet sur la satisfaction utilisateur. Le dirigeant obtient alors une réponse utile : l’outil réduit-il réellement la charge, sans dégrader le service ?
En bref : les repères pour évaluer la qualité des réponses
- Mesurez la résolution réelle, pas seulement le nombre de réponses générées ou de conversations ouvertes.
- Contrôlez l’exactitude et la pertinence des réponses à partir de demandes réelles, classées par motif.
- Suivez l’expérience avec le temps de réponse, les abandons, les transferts et le CSAT.
- Testez les évolutions avant leur mise en production, puis surveillez les résultats après chaque changement.
- Reliez les résultats aux coûts et au travail des équipes pour décider si le dispositif produit une valeur mesurable.
Définir la qualité des réponses d’une IA conversationnelle
La qualité des réponses ne se résume pas à une formulation fluide. Une réponse peut sembler naturelle, mais donner une information erronée, ignorer une partie de la demande ou inventer une règle commerciale. Pour une PME, le critère décisif reste simple : le client a-t-il reçu une réponse correcte et utile, puis pu avancer dans sa démarche ?
Cette évaluation doit couvrir trois dimensions complémentaires. La première est la qualité du contenu : exactitude, précision, pertinence et cohérence avec les informations de l’entreprise. La deuxième concerne l’expérience : compréhension du langage, rapidité, clarté et nombre d’échanges nécessaires. La troisième porte sur l’exploitation : disponibilité, coût par interaction, transferts humains et stabilité des résultats.
Évaluer la réponse, pas seulement sa présentation
Une réponse correcte doit traiter l’intention principale du client et respecter le contexte de la conversation. Si une personne demande si une commande arrivera vendredi, le bot doit vérifier l’état de la livraison, plutôt que répéter une politique générale sur les délais. Une belle phrase qui ne répond pas à la question reste un échec opérationnel.
Pour structurer l’évaluation des réponses, une grille en trois niveaux suffit souvent au démarrage. « Correct » signifie que la réponse est exacte, adaptée et complète. « Acceptable » désigne une réponse utile, mais maladroite ou incomplète sur un détail secondaire. « Incorrect » signale une erreur, une mauvaise compréhension ou une affirmation non vérifiée qui nécessite une correction.
Cette grille doit préciser les règles métier importantes. Un bot de commerce peut recevoir une tolérance limitée sur le ton, mais aucune sur une politique de remboursement. Dans un cabinet médical, une réponse doit respecter un périmètre strict et orienter vers un professionnel lorsqu’une demande sort du cadre autorisé. La gravité de l’erreur dépend donc du secteur et du risque associé.
Construire une base de test représentative
Les exemples inventés par l’équipe produit ne reflètent pas toujours la façon dont les clients s’expriment. Les demandes réelles comprennent des fautes, des phrases incomplètes, des accents, des changements de sujet et des formulations indirectes. Un ensemble de 500 à 1 000 conversations historiques constitue un point de départ exploitable pour tester les principaux motifs, si les données sont correctement anonymisées.
Chaque conversation doit être étiquetée par intention, résultat attendu et niveau de risque. Une PME peut distinguer le suivi de commande, la facturation, la prise de rendez-vous et les réclamations. Cette segmentation évite qu’une bonne moyenne générale masque une faiblesse grave sur les demandes sensibles. Les méthodes d’évaluation de la qualité des réponses des chatbots offrent un cadre utile pour formaliser cette vérification.
Enfin, l’évaluation automatique peut accélérer l’analyse de grands volumes, mais elle ne remplace pas le jugement humain. Faites noter un échantillon par des collaborateurs qui connaissent les règles métier. Comparez leurs décisions avec les scores automatiques et corrigez les divergences. La qualité commence par une définition commune de ce qu’est une réponse acceptable.
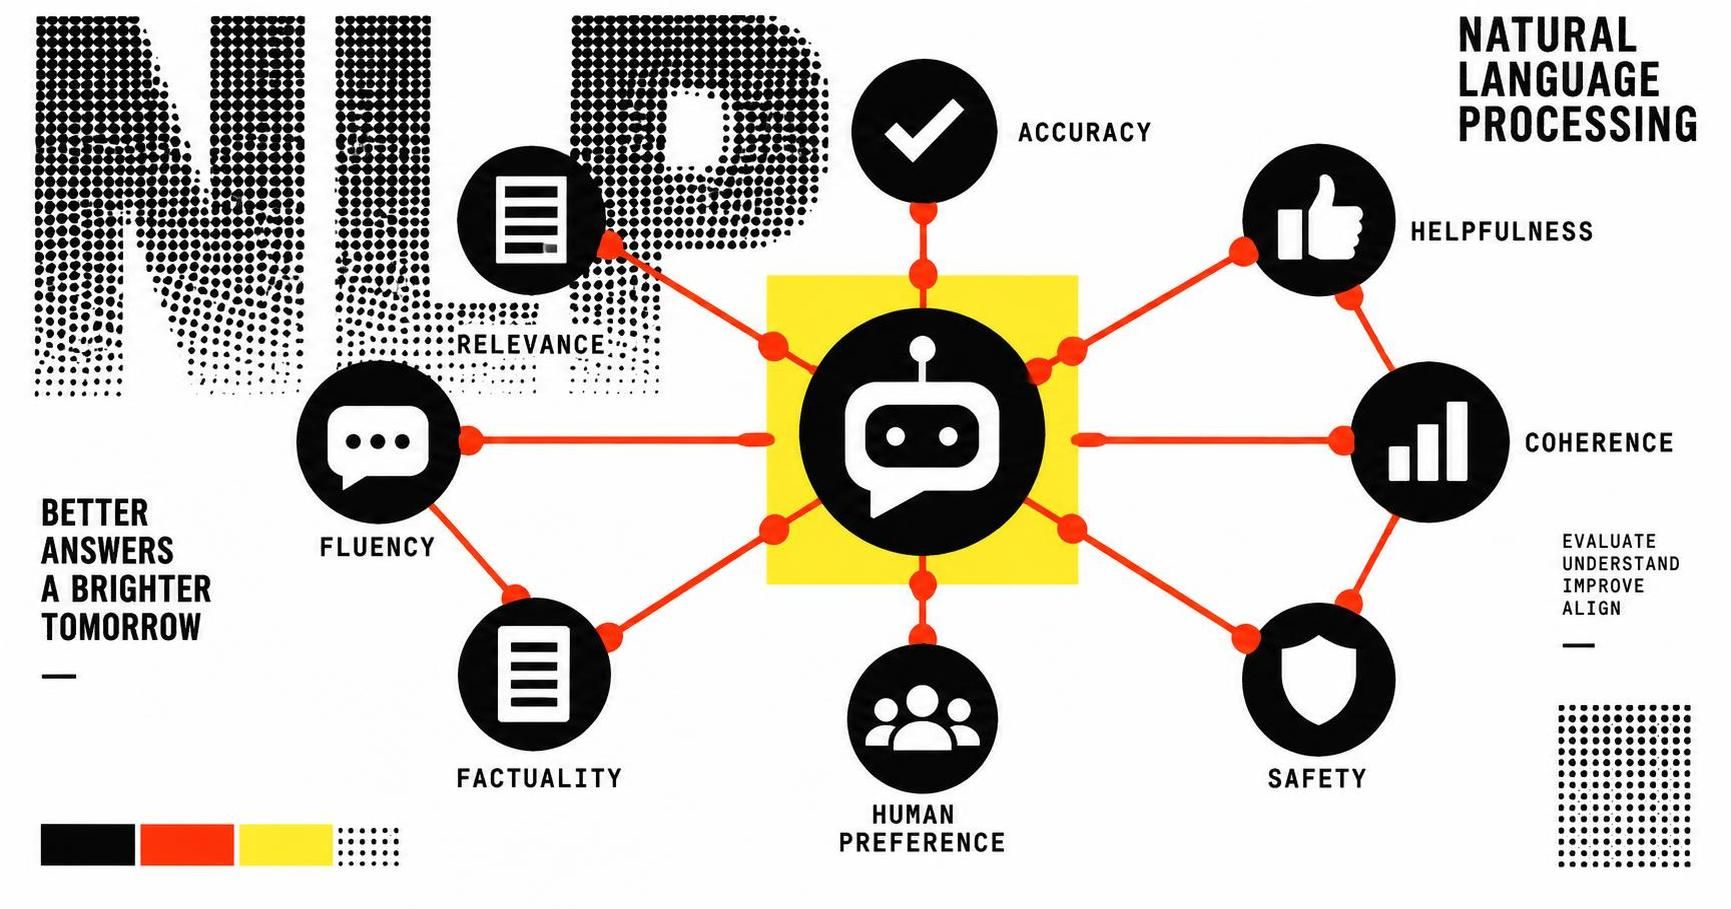
Choisir les indicateurs de performance qui révèlent les vrais résultats
Un tableau de bord utile répond à des questions de direction. L’outil résout-il des demandes sans agent ? Les clients obtiennent-ils une réponse satisfaisante ? Le dispositif réduit-il le coût de traitement ? Pour éviter de noyer l’équipe sous les chiffres, commencez par cinq indicateurs au maximum et rattachez chacun à une décision opérationnelle.
Le taux de résolution automatisée mesure la part des demandes closes dans le canal automatisé, sans intervention humaine. Le taux d’automatisation, lui, indique la part des échanges pris en charge par l’outil, même si certains sont ensuite transférés. Ces deux valeurs ne sont pas interchangeables : un bot peut engager beaucoup de conversations sans résoudre les problèmes associés.
Lire ensemble résolution, escalade et exactitude
Le taux d’escalade indique la proportion de conversations transmises à un collaborateur. Un transfert n’est pas forcément un échec. Il devient problématique lorsque le bot aurait pu traiter une demande simple, ou lorsqu’il transmet un dossier sans résumé ni informations utiles. À l’inverse, une escalade rapide protège le client lorsqu’une demande sensible dépasse le périmètre automatisé.
Suivez aussi la reconnaissance des intentions et l’exactitude des réponses. Les erreurs de reconnaissance vocale peuvent être mesurées avec le WER, qui compare les mots transcrits aux mots prononcés. Un seuil proche de 5 % peut servir de repère technique, mais le résultat acceptable varie selon l’usage. Un numéro de commande mal entendu peut bloquer une demande ; une erreur sur un contenu réglementé peut entraîner un risque bien supérieur.
Pour la justesse factuelle, séparez les questions générales des sujets à risque. Un niveau de 80 % d’exactitude peut constituer un repère initial pour des demandes simples, tandis que les usages portant sur les paiements ou des informations sensibles exigent une exigence nettement plus élevée. La cible doit être définie avant le lancement, selon le coût d’une erreur, et non après coup pour rendre le résultat présentable.
Relier qualité, expérience et coût
| Indicateur | Question de pilotage | Action si le résultat baisse |
|---|---|---|
| Taux de résolution | La demande est-elle réglée sans agent ? | Analyser les motifs non résolus et les transferts. |
| Exactitude des réponses | L’information fournie est-elle vérifiable ? | Corriger la base de connaissances ou les règles de réponse. |
| Temps de résolution | Combien de temps faut-il pour aboutir ? | Repérer les questions répétées et les étapes inutiles. |
| CSAT | Le client juge-t-il l’échange satisfaisant ? | Lire les verbatims et examiner les parcours concernés. |
| Coût par interaction | Le traitement automatisé coûte-t-il moins cher ? | Inclure licence, intégration, maintenance et supervision. |
Un CSAT de 70 à 80 % peut représenter un repère de départ dans certains contextes, mais il ne constitue pas une norme universelle. Comparez-le à votre niveau antérieur et à celui des demandes traitées par un humain. Les verbatims expliquent souvent les variations : une note basse liée à une réponse hors sujet appelle une correction différente d’une note basse liée à un délai de transfert.
Pour approfondir le choix des mesures, consultez ce guide sur les KPI d’un chatbot IA et leur interprétation. Un indicateur n’a de valeur que s’il conduit à une action vérifiable.
Mesurer l’expérience : délais, compréhension et satisfaction utilisateur
La rapidité attire l’attention, mais une réponse instantanée n’est pas nécessairement utile. Il faut distinguer le temps de première réponse du temps total de résolution. Le premier mesure la réactivité perçue ; le second indique le temps réellement nécessaire pour régler le besoin. Si le bot répond vite, puis demande plusieurs fois la même information, l’expérience reste pénible.
Mesurez également le nombre de tours nécessaires avant une solution, le taux d’abandon et la fréquence des reformulations. Une hausse des reformulations peut signaler une compréhension du langage insuffisante, une mauvaise détection d’intention ou un parcours trop rigide. Ces signaux sont particulièrement importants sur le canal vocal, où les clients ne peuvent pas simplement relire une réponse.
Interpréter les résultats selon le parcours
Une demande de suivi de commande ne se traite pas comme une réclamation de paiement. Pour la première, la connexion au système logistique et la rapidité dominent. Pour la seconde, l’exactitude, la confidentialité et la possibilité de parler à une personne deviennent prioritaires. Un score global ne permet donc pas de juger ces parcours avec assez de précision.
Dans une PME de distribution, par exemple, le bot peut répondre en quelques secondes sur la disponibilité d’un produit. Si l’information provient d’un stock mis à jour avec retard, la vitesse ne compense pas l’erreur. Le responsable doit croiser le temps de réponse avec la justesse des données et le taux de contacts répétés dans les jours suivants.
Pour un voicebot, la latence de bout en bout influence directement le naturel de l’échange. Un délai inférieur à 500 millisecondes avant le premier retour vocal constitue un objectif technique utile pour viser une interaction fluide. Ce chiffre dépend toutefois de l’infrastructure, de la région, du réseau et du mode de traitement. Il doit être mesuré dans les conditions réelles de l’entreprise, pas uniquement dans un environnement de démonstration.
Associer scores et retours clients
Le CSAT recueilli après l’échange donne une indication immédiate, mais il ne raconte pas toute l’histoire. Certains clients répondent rarement aux enquêtes ; d’autres évaluent le résultat commercial plutôt que la conversation. Analysez les commentaires libres, les demandes répétées et les conversations abandonnées pour compléter le score.
L’analyse des sentiments peut aider à repérer les échanges qui se dégradent. Elle ne doit pas être traitée comme une vérité absolue : sarcasme, expressions régionales et contexte peuvent fausser la classification. Une alerte de sentiment négatif doit donc déclencher une vérification, et non une décision automatique sans contrôle.
Les tests conversationnels doivent couvrir des dialogues complets, pas seulement une question isolée. Vérifiez si le bot conserve le contexte après une précision, gère une correction et répond sans se contredire. Pour une entreprise qui automatise les appels, il est aussi utile de comparer les exigences de l’IA vocale conversationnelle avec celles du canal écrit. Les deux canaux partagent des objectifs, mais pas toujours les mêmes contraintes de délai ou de compréhension.
Les recommandations de mesure de l’exactitude et des biais rappellent l’intérêt d’examiner les résultats selon les profils et les formulations. La satisfaction utilisateur se comprend mieux quand le score est relié à une conversation précise.
Organiser les tests conversationnels avant et après le lancement
Une IA conversationnelle change avec les contenus, les règles métier et parfois les modèles qui la font fonctionner. Une réponse jugée fiable le mois dernier peut devenir imprécise après une modification de consigne ou de base documentaire. Les tests ne sont donc pas une formalité de lancement : ils doivent accompagner toute évolution importante.
Avant la mise en production, préparez des scénarios couvrant les demandes fréquentes, les cas limites et les situations sensibles. Testez la réponse immédiate, mais aussi la conversation à plusieurs tours. Une simulation doit vérifier que le bot comprend une précision, corrige une mauvaise interprétation et propose un transfert lorsque cela s’impose.
Tester sans brouiller les résultats
Les tests A/B permettent de comparer deux formulations d’accueil, deux voix ou deux parcours. Pour interpréter le résultat, ne changez qu’un élément à la fois. Si vous modifiez simultanément le message d’accueil, les consignes et la base de connaissances, vous ne saurez pas quel changement a amélioré ou détérioré la performance.
Le volume de conversations est souvent plus faible que le trafic d’un site web. Une expérimentation peut donc devoir durer plusieurs semaines pour produire un signal exploitable. Si le volume est réduit, privilégiez des changements suffisamment visibles et complétez les résultats quantitatifs par une revue humaine des échanges. Les détails pratiques de l’évaluation des agents conversationnels donnent des pistes pour articuler tests automatisés et vérifications manuelles.
Pour une PME, une grille de contrôle simple peut couvrir les éléments suivants :
- Intention : l’agent a-t-il compris le besoin réel, même si la demande comporte une faute ou une formulation indirecte ?
- Exactitude : chaque information donnée correspond-elle à une source interne à jour ?
- Continuité : le bot conserve-t-il les informations déjà fournies pendant l’échange ?
- Transfert : le passage à un agent humain intervient-il au bon moment, avec le bon contexte ?
- Résultat : le client a-t-il obtenu une solution ou une prochaine étape compréhensible ?
Prévenir les régressions en production
Après chaque changement important, rejouez les scénarios de référence. Conservez les versions des consignes, des bases de connaissances et des parcours afin de comparer les résultats et de revenir à une configuration antérieure si nécessaire. Cette précaution évite qu’une amélioration sur un motif crée une dégradation ailleurs.
Les tests d’appels d’outils sont essentiels dès que le bot consulte un CRM, un logiciel de commande ou un agenda. Vérifiez que les paramètres transmis sont corrects et que l’outil ne modifie pas une donnée sans validation. Ajoutez aussi des essais adversariaux : demandes hors sujet, tentatives de contournement des consignes et requêtes contenant des informations contradictoires.
Un contrôle humain hebdomadaire d’un échantillon aide à repérer les anomalies que les scores agrégés masquent. Les erreurs récurrentes doivent ensuite rejoindre le jeu de test, pour éviter qu’elles réapparaissent après une mise à jour. Des outils comme l’analyse des conversations de chatbot peuvent soutenir ce suivi, à condition de conserver une responsabilité métier clairement attribuée.
Si l’entreprise hésite entre l’automatisation du téléphone et celle du texte, elle peut comparer les tâches, les délais et les risques à partir de son propre volume. L’analyse des différences entre IA téléphonique et IA textuelle aide à choisir un périmètre de test réaliste. Un lancement progressif protège les clients et rend les corrections moins coûteuses.
Transformer les mesures en décisions et en ROI durable
Le pilotage ne s’arrête pas à la qualité des réponses. Il doit montrer si l’automatisation améliore le fonctionnement de l’entreprise. Calculez le coût complet : abonnement, intégration, maintenance, supervision, formation et temps consacré à la mise à jour des contenus. Comparez-le aux gains réellement observés, plutôt qu’à des économies théoriques annoncées avant le projet.
Les gains peuvent inclure les heures économisées sur les demandes répétitives, la baisse du coût par interaction et la capacité à absorber les pics sans augmenter immédiatement les effectifs. Ajoutez les coûts évités liés aux erreurs ou aux contacts répétés, mais ne comptez pas deux fois le même bénéfice. Une mesure avant-après sur un périmètre précis rend l’estimation plus crédible qu’une projection générale.
Construire un tableau de bord utile à la direction
Une PME de services peut commencer avec trois motifs fréquents, comme la prise de rendez-vous, les horaires et le suivi d’intervention. Elle mesure les résultats avant l’automatisation, puis suit chaque mois la résolution, les transferts, la satisfaction et le coût. Si les résultats progressent sur les demandes simples sans faire baisser la satisfaction, l’entreprise peut élargir progressivement le périmètre.
Le tableau de bord doit relier chaque chiffre à une personne responsable et à une action possible. Une baisse de résolution peut appeler une correction documentaire ; une hausse des transferts peut nécessiter un meilleur routage ; une hausse des abandons peut révéler un parcours trop long. Sans cette attribution, les indicateurs restent des graphiques consultés sans conséquence.
Le suivi interne compte également. Les agents doivent pouvoir signaler les réponses inadaptées et comprendre les informations que le bot transmet lorsqu’il leur passe la main. Si les collaborateurs contournent l’outil ou corrigent systématiquement ses dossiers, le dispositif peut afficher une bonne automatisation tout en déplaçant la charge de travail.
Faire évoluer le dispositif sans perdre la maîtrise
Pour commencer, fixez une situation de référence, choisissez quelques motifs et définissez des seuils adaptés au risque. Examinez les résultats à intervalles réguliers avec le service client, la direction et la finance. Une solution comme AirAgent peut s’inscrire dans cette démarche si son périmètre, ses coûts et ses résultats sont évalués avec les mêmes critères que les autres options.
Comparez les performances par intention, canal et période. Une moyenne peut cacher une réussite sur les questions de livraison et un échec sur les réclamations. Une segmentation claire indique où renforcer les contenus, où simplifier le parcours et où conserver une prise en charge humaine directe.
La boucle d’amélioration doit rester courte : analyser les erreurs, corriger une cause identifiée, tester la modification, puis vérifier son effet en production. Des ressources comme les critères de comparaison des callbots peuvent aider à confronter les outils, mais aucune note externe ne remplace vos propres résultats. Le bon dispositif est celui qui améliore durablement le service, avec des preuves lisibles pour la direction et les équipes.
Questions fréquentes sur la mesure de la qualité des réponses
Quels indicateurs suivre en premier pour évaluer une IA conversationnelle ?
Commencez par le taux de résolution, l’exactitude des réponses, le temps de résolution, le taux de transfert et la satisfaction client. Choisissez les indicateurs selon vos objectifs et les risques liés à chaque demande. Une moyenne globale doit toujours être complétée par une lecture par motif.
Comment vérifier qu’une réponse est réellement correcte ?
Comparez-la à une source métier validée et à une réponse attendue définie par votre équipe. Évaluez aussi si elle répond à l’intention, respecte le contexte et indique ses limites. Faites contrôler régulièrement un échantillon de conversations par des collaborateurs qui connaissent les règles de l’entreprise.
Quel score de satisfaction viser ?
Il n’existe pas de seuil universel. Un CSAT de 70 à 80 % peut servir de repère initial, mais comparez surtout le résultat à votre niveau de départ et aux échanges traités par des humains. Analysez les commentaires négatifs pour comprendre les causes concrètes.
À quelle fréquence faut-il tester les réponses du bot ?
Contrôlez les conversations chaque semaine sur un échantillon, puis relancez les tests après toute modification importante des consignes, des données ou des parcours. Suivez les indicateurs chaque mois. Les secteurs sensibles nécessitent des vérifications plus strictes et un processus de validation documenté.
L’automatisation doit-elle résoudre toutes les demandes sans agent ?
Non. Les demandes répétitives se prêtent bien à l’automatisation, mais les situations complexes, sensibles ou ambiguës doivent pouvoir être transférées rapidement. Un transfert bien préparé protège l’expérience client et évite de pousser le bot au-delà de ses capacités fiables.